체계적 문헌고찰 메타분석 차이: 무엇이 다르고 어떤 순서로 하는가
체계적 문헌고찰은 방법이고 메타분석은 그 안에서 조건이 맞을 때 쓰는 통계 단계입니다. 메타분석을 해도 되는지 판단하는 네 가지 질문과 가상의 예시, 국내 데이터베이스 맥락을 정리했습니다.
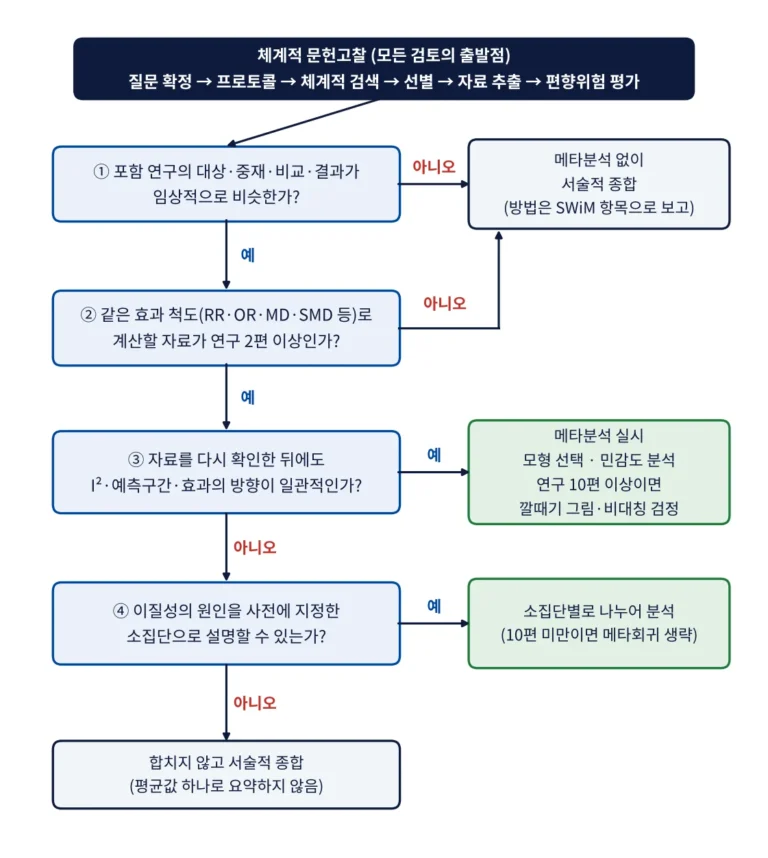
체계적 문헌고찰은 방법이고 메타분석은 그 안에서 조건이 맞을 때 쓰는 통계 단계입니다. 메타분석을 해도 되는지 판단하는 네 가지 질문과 가상의 예시, 국내 데이터베이스 맥락을 정리했습니다.

결측 기전의 세 가지 유형, 피해야 할 임시방편, 다중대체의 원리와 함정, 그리고 STROBE·CONSORT 2025와 방법론 문헌이 요구하는 결측 자료 보고 항목을 정리했습니다.
모든 저널에 공통인 통계 보고 원칙과 APA 7판의 표기 규칙, 의학 저널 지침의 예를 비교하고, 같은 결과를 두 스타일로 쓴 예시와 국내 원고의 흔한 실수를 정리했습니다.

다중비교 보정이 필요한 이유와 반대 논리, FWER와 FDR의 차이, Bonferroni·Holm·Benjamini–Hochberg 방법을 같은 예시로 비교하고 논문 보고 방법을 정리했습니다.
관찰연구와 중재연구를 가르는 기준, 각 설계가 적합한 연구 질문, 그리고 설계 선택이 임상시험 등록과 보고 지침 의무로 어떻게 이어지는지를 흐름도와 함께 정리했습니다.

p-value가 실제로 의미하는 것과 흔한 오해, 통계적 유의성과 임상적 유의성의 차이, 효과 크기와 신뢰구간 중심으로 결과를 쓰는 방법을 ASA 성명과 방법론 문헌을 근거로 정리했습니다.

세 통계 프로그램의 구조적 차이를 공식 자료로 정리하고, 학위논문·공동연구·임상시험 등 상황별 선택 기준과 어떤 프로그램을 쓰든 지켜야 할 재현성·보고 원칙을 다룹니다.
이미 쌓여 있는 데이터로 논문을 쓰는 일은 새로 환자를 모집하는 것보다 훨씬 빠르다. 그래서 후향적 코호트 연구는 국내 임상 연구자와 대학원생이 가장 자주 선택하는 설계다. 문제는 데이터가 이미 존재한다는 바로 그 사실이 설계 단계의 판단을 건너뛰게 만든다는 점이다. 노출군을 어떻게 정의하느냐에 따라 결과가 통째로 뒤집히는 편향이 있고, 교란변수를 p값으로 골라내는 관행은 이미 1996년에 부적절하다고 지적됐으며[9],…

한국은 전 국민 단일 건강보험 체계 덕분에 연구자 입장에서는 매우 드문 자산을 갖고 있다. 국민의 97%가 국민건강보험에 가입돼 있고 대부분이 연 1회 이상 의료를 이용하므로, 청구자료만으로도 사실상 전 국민 규모의 코호트를 구성할 수 있다.[8] 그럼에도 국내 보건의료 빅데이터를 이용한 논문 계획이 중간에 멈추는 경우가 적지 않은데, 원인은 대체로 데이터가 없어서가 아니라 어느 데이터베이스가 자신의 연구…

관찰연구에서 “A가 B를 일으킨다”고 말하기 어려운 이유는 잘 알려져 있다. 교란(confounding)과 역인과(reverse causation)를 완전히 배제할 수 없기 때문이다. 멘델 무작위화(Mendelian randomization, MR)는 이 문제를 유전변이를 도구변수(instrumental variable)로 사용해 우회하려는 방법이다. 2003년 Davey Smith와 Ebrahim이 International Journal of Epidemiology에 발표한 논문이 이 접근을 역학 연구의 방법론으로 정식화했고, 그 핵심 논거는 부모에서 자녀로 대립유전자가 무작위로 배분되는 감수분열…