AI 탐지기 오탐: 비원어민 연구자의 글이 왜 걸리는가
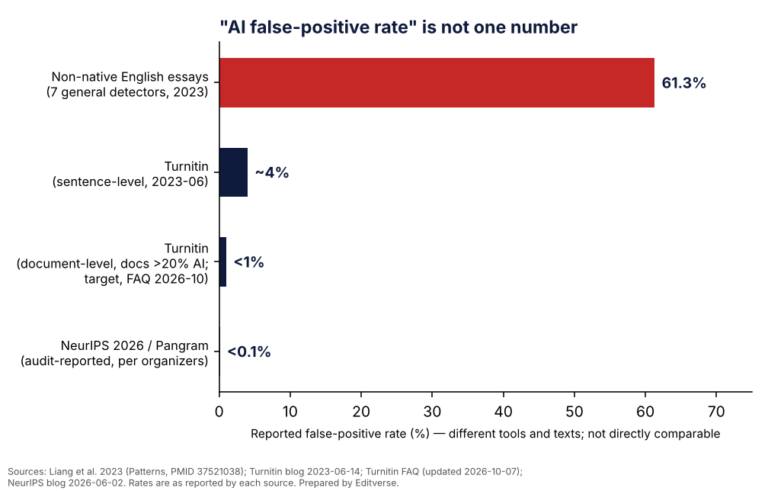
AI 탐지기가 사람이 직접 쓴 글을 AI가 쓴 글로 표시하는 일, 곧 AI 탐지기 오탐은 비원어민 연구자에게 특히 자주 보고됩니다. 스탠퍼드 연구팀이 2023년 Patterns에 발표한 연구에서는 중국의 한 포럼에서 수집한 TOEFL 에세이 91편을 탐지기 7종에 넣었더니 평균 61.3%가 AI가 쓴 글로 잘못 분류되었고, 89편(97.8%)이 적어도 한 곳에서 AI 글로 판정되었습니다.[1] 이 글은 탐지 점수가 무엇을 뜻하는지, 연구와 기관이 어떤 입장을 보이는지, 오탐 가능성에 대비해 어떤 작성 기록을 남겨 두면 좋은지를 정리합니다.
간단히 말하면
- AI 탐지 점수는 “누가 썼는가”에 대한 판정이 아니라 텍스트의 통계적 특성에 근거한 추정입니다.
- 비원어민 영어 텍스트에서 오탐이 더 많이 보고되었지만, 연구마다 대상 텍스트와 판정 기준이 달라 숫자 하나로 요약할 수 없습니다.
- Turnitin은 자사 지표를 조치의 단독 근거로 쓰지 말라고 안내하고, 일부 대학은 이 기능을 꺼 두기도 했습니다.
- 필요한 대비는 점수를 맞추는 일이 아니라 작성 기록을 보관하고, AI 도구를 썼다면 규정대로 공개하고, 대상 학술지와 기관의 규정을 확인하는 것입니다.
탐지 점수가 실제로 말해 주는 것
Liang 등에 따르면 많은 GPT 탐지기는 텍스트의 perplexity(당혹도)를 활용합니다. perplexity는 언어모델이 문장의 다음 단어를 맞히려 할 때 얼마나 “놀라는가”를 나타내는 값으로, 다음 단어를 쉽게 예측할 수 있으면 낮아집니다.[1] 예측하기 쉬운 글이 AI가 쓴 글처럼 보일 수 있다는 점이 이 방식의 구조적 한계입니다.
Turnitin의 자주 묻는 질문(FAQ) 페이지는 이 지표의 사용 조건을 이렇게 안내합니다. 산문 형식의 텍스트가 300단어 이상이어야 하고 3만 단어를 넘을 수 없으며, AI 비율이 1~19%인 구간은 숫자 대신 별표(*%)로 표시합니다. 또한 이 지표는 부정행위의 판정이 아니며 조치의 단독 근거로 쓰면 안 된다고 밝힙니다.[2] (페이지에 표시된 갱신일은 2026년 10월 7일입니다.)
숫자의 의미는 도구마다 다릅니다. NeurIPS 2026 포지션 논문 트랙 운영진은 Pangram 점수 100%를 “텍스트의 100%가 AI가 쓴 것”으로 해석하면 안 되고, 텍스트의 여러 부분에서 AI가 상당히 쓰였다는 뜻이라고 설명했습니다.[3]
연구 결과를 나란히 보면
탐지기 오탐을 다룬 주요 연구를 표로 정리했습니다. 대상 텍스트, 탐지기, 판정 기준이 모두 달라 숫자끼리 직접 비교할 수는 없습니다.
| 연구 | 대상과 방법 | 결과와 유의점 |
|---|---|---|
| Liang 등, 2023 (Patterns)[1] | 중국 포럼의 TOEFL 에세이 91편(비원어민)과 미국 8학년 에세이 88편, 탐지기 7종 | TOEFL 에세이 평균 오탐률 61.3%. 7종 모두가 AI로 판정한 에세이 19.8%, 적어도 한 종이 판정한 에세이 97.8%. 미국 학생 에세이는 정확히 분류됨. 시험 에세이이고 2023년 시점의 도구라는 점을 감안해야 함 |
| Erol 등, 2025 (Acta Neurochirurgica)[4] | ChatGPT 이전에 발표된 신경외과 학술지의 사람이 쓴 논문 250편과 ChatGPT 생성 텍스트 750편, 탐지기 3종 | 사람이 쓴 논문 중 AI 점수 50%를 넘은 수는 Corrector App 76편(30.4%), ZeroGPT 40편(16%), GPTZero 0편. AI 생성 텍스트는 대체로 구분되었지만(AUC 0.75~1.00) 어느 탐지기도 100% 신뢰할 수 없었고, 저자들은 탐지기를 확정적 해법이 아닌 보조 도구로 봐야 한다고 결론 내림 |
| Popkov & Barrett, 2025 (Accountability in Research)[5] | 행동건강·정신의학 저널 논문 100편(2016~2018년)과 챗봇 생성 텍스트 200편 | 무료 탐지기는 사람이 쓴 학술 텍스트의 중앙값 27.2%를 AI로 판정. 유료 Originality.AI는 더 나았지만 한계가 있었음. 저자들은 탐지기로 엄격한 정책을 집행하는 데 의문을 제기함 |
| Weber-Wulff 등, 2023 (Int J Educ Integr)[6] | 공개 도구 12종과 상용 시스템 2종(Turnitin, PlagiarismCheck) | 도구들이 “정확하지도 신뢰할 만하지도 않으며”, 주로 사람이 쓴 글로 분류하는 쪽으로 치우쳤다고 결론. 즉 오탐뿐 아니라 AI 글을 놓치는 오류도 문제임 |
| Turnitin 자체 분석, 2023-10[7] | ASAP, PELIC, ICNALE 데이터의 L1·L2 영어 텍스트(조합별 최대 2,000건), 300단어 이상과 150~300단어 | 300단어 이상에서는 두 집단의 오탐률 차이가 작고 통계적으로 유의하지 않았고, 150~300단어에서는 차이가 더 컸다고 보고. 제작사가 직접 수행한 분석이며, L2 텍스트 대부분이 짧은 중등 수준 에세이라고 밝힘 |
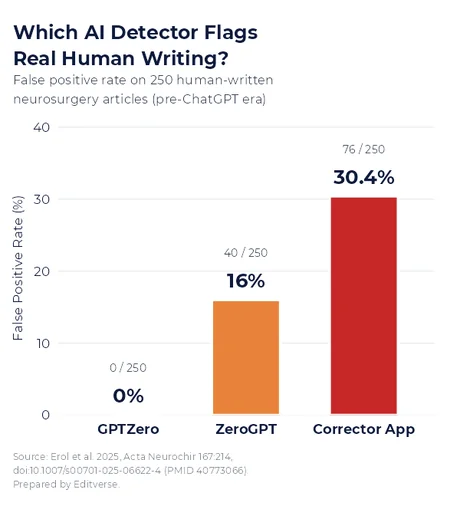
비원어민의 글에서 오탐이 더 자주 보고되는 이유
Liang 등은 7종 모두가 AI로 판정한 TOEFL 에세이의 perplexity가 유의하게 낮았다고 보고했습니다.[1] 이들은 비원어민 작성자의 글이 어휘의 풍부함, 통사의 다양성, 문법적 복잡성 면에서 변화가 적은 경향이 있고, 그만큼 언어모델이 다음 단어를 예측하기 쉽다고 해석합니다. ICLR 2023 논문을 분석한 결과도 같은 방향이었습니다. 영어가 모국어가 아닌 나라 출신 제1저자의 논문은 모국어가 영어인 나라 출신 저자의 논문보다 perplexity가 낮았고, 이 차이는 심사 점수를 보정한 뒤에도 유지되었습니다.[1]
저자들은 이를 근거로 평가나 교육 현장, 특히 비원어민의 글을 평가하는 데 GPT 탐지기를 쓰는 것을 강하게 경계했고, 낮은 perplexity를 AI 생성의 지표로 쓰면 학계의 구조적 편향을 키울 수 있다고 지적했습니다.[1]
이 근거에는 한계도 있습니다. 첫째, 판정 실험의 대상은 학술 논문이 아니라 TOEFL 시험 에세이입니다. 둘째, 2023년 시점의 도구에서 얻은 결과이므로 현재 버전의 개별 제품에 그대로 대입할 수 없습니다. 셋째, Turnitin은 300단어 이상의 텍스트에서는 L1과 L2 집단의 차이가 통계적으로 유의하지 않았다고 보고했지만, 이는 제작사가 직접 수행한 분석입니다.[7] 한편 표의 Erol 등과 Popkov & Barrett 연구는 초록에서 비원어민 여부를 분석 대상으로 언급하지 않았지만, 사람이 쓴 학술 텍스트에서도 오탐이 나타날 수 있음을 보여 줍니다.[4][5]
기관과 학술지는 탐지 점수를 어떻게 다루나
아래는 각 기관이 밝힌 입장입니다. 모두 해당 기관 한 곳의 입장이며, 다른 기관이나 학술지에 일반화할 수 없고, 기준일은 괄호에 적었습니다.
- Turnitin(FAQ 갱신일 2026-10-07): 지표는 부정행위의 판정이 아니며 단독 근거로 쓰면 안 됩니다. 문서 단위 오탐률은 AI 작성 비율이 20%를 넘는 문서 기준 1% 미만을 목표로 한다고 안내하고,[2] 문장 단위 오탐률은 약 4%이며 사람 글과 AI 글이 이어지는 경계에서 더 흔하다고 2023년 6월 블로그에서 밝혔습니다.[8]
- 밴더빌트대학교(2023-08-16): Turnitin의 AI 탐지 기능을 당분간 끄기로 했습니다. 2022년 한 해 7만 5천 편을 제출했고 오탐률 1%를 적용하면 약 750편이 잘못 표시될 수 있다고 계산했으며, AI 탐지기가 비원어민의 글을 AI 글로 표시할 가능성이 더 높다는 점도 언급했습니다.[9]
- ICMJE(V.A, 2026년 1월 갱신 표기): 기준은 점수가 아니라 사용 사실의 공개입니다. AI 사용은 투고 시 공개해야 하고, AI는 저자가 될 수 없으며, 저자가 책임을 집니다. 공개하지 않으면 시정 조치가 필요할 수 있고 일부 상황에서는 부정행위로 간주될 수 있습니다.[10]
- COPE: AI 도구는 저자가 될 수 없고, 사용했다면 Materials and Methods 등에 투명하게 밝히며, 저자가 책임을 집니다.[11]
- NeurIPS 2026 포지션 논문 트랙(2026-06-02): 이 트랙의 AI 사용 정책에 따라 Pangram 점수와 저자의 AI 사용 선언 등 추가 기준을 함께 적용해 969편 중 178편(18.4%)을 통상 이의제기 대상이 아닌 desk reject로 처리했고, 123편(12.7%)에는 실질적인 사람의 참여를 보여 주는 증거를 요구했습니다. 증거는 온라인 버전 기록에서 AI 사용 이전 시점, AI가 쓴 부분을 넣은 직후 시점, 제출본의 세 지점을 밝히는 형식이었고, 운영진은 AI를 광범위하게 쓴 저자가 작성 과정의 기록을 유지해야 한다고 밝혔습니다. 같은 글에서 창 크기 설정을 바꾸자 90~100% 구간 논문의 비율이 42.7%에서 12.7%로 달라졌다고도 보고했습니다. 학회 한 곳의 특정 정책 사례이며 저널 일반의 기준이 아닙니다.[3]
- 연세대 도메인(arch.yonsei.ac.kr)의 한 공지에 첨부된 “연구자를 위한 생성형 AI 활용 지침”(ver 1.0, 2025년 8월): 생성형 AI를 쓰면 도구명, 버전, 제작사와 사용 목적을 기재하고, 학술지 제출 전에 iThenticate-AI Detection 등으로 점검하되 결과는 참고 자료로 활용하라고 안내합니다. 문서에 발행 부서가 표기되어 있지 않으므로 소속 기관의 현행 지침을 따로 확인해야 합니다.[12]
- 한국연구재단(NRF)(웹진 2024년 3월호): NRF 지원 과제의 신청자와 수행자가 연구개발계획서와 단계·최종보고서 작성에 생성형 AI 도구를 썼다면 해당 문서에 사용 내역을 기술하도록 권장합니다.[13]
한국어 원고와 국내 도구는 어떻게 봐야 할까
Turnitin FAQ가 안내하는 AI 작성 탐지 언어 목록은 영어, 스페인어, 일본어, 현대 아랍어, 네덜란드어, 독일어, 터키어이며 한국어는 없습니다(2026년 10월 7일 갱신 표기).[2] 한국어 원고에 이 지표가 적용되는지는 대상 기관에 직접 확인해야 합니다.
국내 도구인 카피킬러는 문서별로 표절률과 AI작성률을 각각 산출한다고 소개하고, “한국어 문장 구조에 최적화된 자체 판별 기술”을 쓴다고 밝힙니다.[14] 2026년 10월 11일에 PubMed에서 “GPTKiller”, “Copykiller”, “Muhayu”로 검색했을 때는 이 도구의 정확도를 평가한 논문이 나오지 않았습니다. 점수를 읽는 방법은 카피킬러 GPT킬러 점수 해석 글에서, 대학원별 표절 검사 기준은 학위논문 표절 검사 기준 비교 글에서 정리했습니다. 어느 도구든 숫자의 기준은 대학원과 학술지가 정하므로, 소속 기관의 공지와 투고 규정을 먼저 확인하는 것이 순서입니다.
오탐 가능성에 대비해 남겨 둘 작성 기록
NeurIPS 사례에서 보듯 이의나 소명을 요구받으면 기한 안에 작성 과정을 보여 주는 기록이 필요할 수 있습니다.[3] 탐지 결과와 무관하게 연구 과정에서 자연스럽게 쌓이는 자료이므로, 처음부터 날짜가 남는 형태로 보관해 두면 됩니다.
| 기록 | 담을 내용 | 예시 |
|---|---|---|
| 버전 기록 | Word 변경 내용 추적, Google Docs 버전 기록처럼 날짜가 남는 형태의 초고 이력 | 가상의 예시: 3월 2일 한국어 개요, 3월 20일 영문 1차본, 4월 5일 공저자 검토본 |
| 원자료와 분석 기록 | 원자료 파일, 분석 코드와 실행 기록, 그림·표의 원본 파일 | 가상의 예시: 분석 스크립트와 실행 로그, 그림 원본 파일 |
| 문헌 노트 | 읽은 논문 목록과 메모, 인용 문장의 출처 표시 | 가상의 예시: 논문별 요약 메모와 참고문헌 관리 파일 |
| AI 도구 사용 기록 | 사용했다면 도구명, 버전, 제작사, 사용 목적, 날짜(연세대 지침이 기재를 안내한 항목)[12] | 가상의 예시: 4월 1일 영문 초록 문법 검토, 도구명과 버전은 실제로 쓴 것을 기재 |
| 수정 교신 | 지도교수·공저자의 수정 요청과 반영 내역 | 가상의 예시: 지도교수 코멘트가 달린 검토본 파일 |
점수를 마주했을 때는 아래 순서로 읽습니다.
- 점수의 출처를 확인합니다. 어떤 도구의 어떤 지표(유사도인지 AI 작성인지)이고, 어느 버전과 날짜의 결과인지 봅니다.
- 표시된 구간을 봅니다. 숫자보다 어느 문장과 단락이 표시되었는지, 그 부분의 작성 과정을 보여 주는 기록이 있는지 확인합니다.
- 규정을 확인합니다. 대상 학술지나 기관이 AI 정책과 점수 해석 기준을 문서로 밝혔는지 찾아봅니다. 기준 숫자가 없는 곳도 많습니다.
- 사실대로 설명합니다. 직접 쓴 글이면 작성 기록으로, AI 도구를 썼다면 도구명과 용도를 규정에 맞게 공개해 설명합니다.
- 소명 절차를 확인합니다. 절차가 있다면 기한과 제출 형식을 먼저 확인합니다. NeurIPS의 경우 증거 제출 기한이 정해져 있었습니다.[3]
AI 도구를 썼다면: 점수보다 공개가 기준입니다
ICMJE와 COPE, 그리고 앞서 본 국내 지침은 AI 사용 사실의 공개를 요구합니다.[10][11][12] 번역이나 문법 교정에 AI 도구를 썼다면 도구명과 용도를 투고 규정이 정한 위치에 기재합니다. 공개 방법은 논문에 AI 사용을 저널에 어떻게 공개해야 할까, 출판사별 정책은 2026년 주요 SCI 저널의 AI 작성 논문 감지 정책 총정리, 증명서가 필요한 경우는 AI 증명서가 필요한 경우 글에서 다룹니다.
투고 전 AI 사용 공개 점검이 필요하다면
Editverse의 학술 문체 교정은 원고의 의미와 데이터를 유지하면서 문장을 다듬는 서비스입니다. AI 사용 공개 문구와 저자 표기를 ICMJE 기준과 대상 저널 정책에 맞춰 확인하고 싶다면 아래 투고 전 무결성·정책 점검을 활용할 수 있습니다. 서비스 선택이 어렵다면 문의 페이지 또는 [email protected]으로 원고 상황을 알려 주세요.
프리미엄 학술 편집
분량에 따른 견적
표준 학술 편집에 저널 서식 적용, 커버레터 작성 지원, 리뷰어 답변서 영문 교정을 더했습니다. 게재 확정까지 무료 재교정(동일 원고, 당사 작업 범위).
투고 전 무결성·정책 점검
범위가 정해진 점검
AI 사용 공개 문구와 저자 표기를 ICMJE 기준과 대상 저널 정책에 맞춰 점검하고, 보고 지침·참고문헌·수치까지 확인합니다. 5영업일.
마무리
AI 탐지기 오탐은 비원어민 영어 텍스트에서 특히 높게 보고되었지만, 연구마다 대상과 기준이 달라 하나의 숫자로 말할 수 없습니다. Turnitin을 포함해 탐지 점수를 단독 근거로 삼지 말라는 안내가 있고, 학술지와 기관이 실제로 요구하는 것은 점수가 아니라 AI 사용 사실의 공개입니다. 직접 쓴 글이라면 작성 기록이 가장 분명한 설명이 됩니다. 투고 전에는 대상 학술지와 소속 기관의 규정을 문서로 확인해 두세요.
참고문헌
- Liang W, Yuksekgonul M, Mao Y, Wu E, Zou J. GPT detectors are biased against non-native English writers. Patterns (N Y). 2023;4(7):100779. doi:10.1016/j.patter.2023.100779. PMID: 37521038.
- Turnitin. Turnitin’s AI writing detection capabilities FAQs. Turnitin Guides (페이지 표시 갱신일 2026-10-07, 열람 2026-10-11). guides.turnitin.com.
- NeurIPS Blog. AI-Generated Papers in the NeurIPS 2026 Position Paper Track. 2026-06-02. blog.neurips.cc.
- Erol G, Ergen A, Gülşen Erol B, et al. Can we trust academic AI detective? Accuracy and limitations of AI-output detectors. Acta Neurochir (Wien). 2025;167(1):214. doi:10.1007/s00701-025-06622-4. PMID: 40773066.
- Popkov AA, Barrett TS. AI vs academia: Experimental study on AI text detectors’ accuracy in behavioral health academic writing. Account Res. 2025;32(7):1072-1088. doi:10.1080/08989621.2024.2331757. PMID: 38516933.
- Weber-Wulff D, Anohina-Naumeca A, Bjelobaba S, et al. Testing of detection tools for AI-generated text. Int J Educ Integr. 2023;19:26. doi:10.1007/s40979-023-00146-z.
- Turnitin. New research: Turnitin’s AI detector shows no statistically significant bias against English language learners. 2023-10-26. Turnitin Blog.
- Turnitin. Understanding the false positive rate for sentences of our AI writing detection capability. 2023-06-14. Turnitin Blog.
- Vanderbilt University. Guidance on AI detection and why we’re disabling Turnitin’s AI detector. 2023-08-16. vanderbilt.edu.
- International Committee of Medical Journal Editors (ICMJE). Recommendations: Artificial Intelligence — AI use by authors (V.A, 2026년 1월 갱신 표기). icmje.org.
- Committee on Publication Ethics (COPE). Authorship and AI tools [position statement]. publicationethics.org.
- 연구자를 위한 생성형 AI 활용 지침, ver 1.0 (2025년 8월). arch.yonsei.ac.kr 공지 첨부 PDF(발행 부서는 문서에 표기되지 않음). arch.yonsei.ac.kr.
- 한국연구재단. 생성형 인공지능(AI) 도구의 책임 있는 사용을 위한 권고사항. NRF 웹진 2024년 3월호. webzine.nrf.re.kr.
- 무하유. 카피킬러(Copykiller) 서비스 소개 페이지 (열람 2026-10-11). copykiller.com.
이어서 읽기
원고 상담
이 주제로 원고를 준비 중이신가요?
연구 분야와 원고 단계를 남겨 주시면 PhD·MD·통계 전문가가 검토 방향을 이메일로 안내해 드립니다.
- PhD · 의학박사(MD) · 통계 전문가 · 분야 전문가가 함께 검토
- 선결제 없이 시작, 첫 초안 확인 후 결제
- 대학·기관 지침과 COPE·ICMJE 기준 준수, 비밀유지(NDA)
- 영업일 기준 24시간 이내 이메일 답변